Eigen onderzoek, verschenen op Frankwatching
Wat 142 Nederlandse organisaties in hun robots.txt over AI-crawlers regelen. Mijn eerste artikel op Frankwatching.
- Rol
- Onderzoeker
- Jaar
- 2026
- Diensten
- Vindbaarheid
- Onderzoek
- Data
- Publicatie
Uitdaging
In een robots.txt staat welke crawlers een site wel en niet mogen lezen. Sinds AI-systemen het web lezen, staan daar ook namen als GPTBot en ClaudeBot in. Maar wat regelen Nederlandse organisaties daar nu echt mee? Ik wilde het weten, en ik wilde het meten in plaats van erover te schrijven.
Oplossing
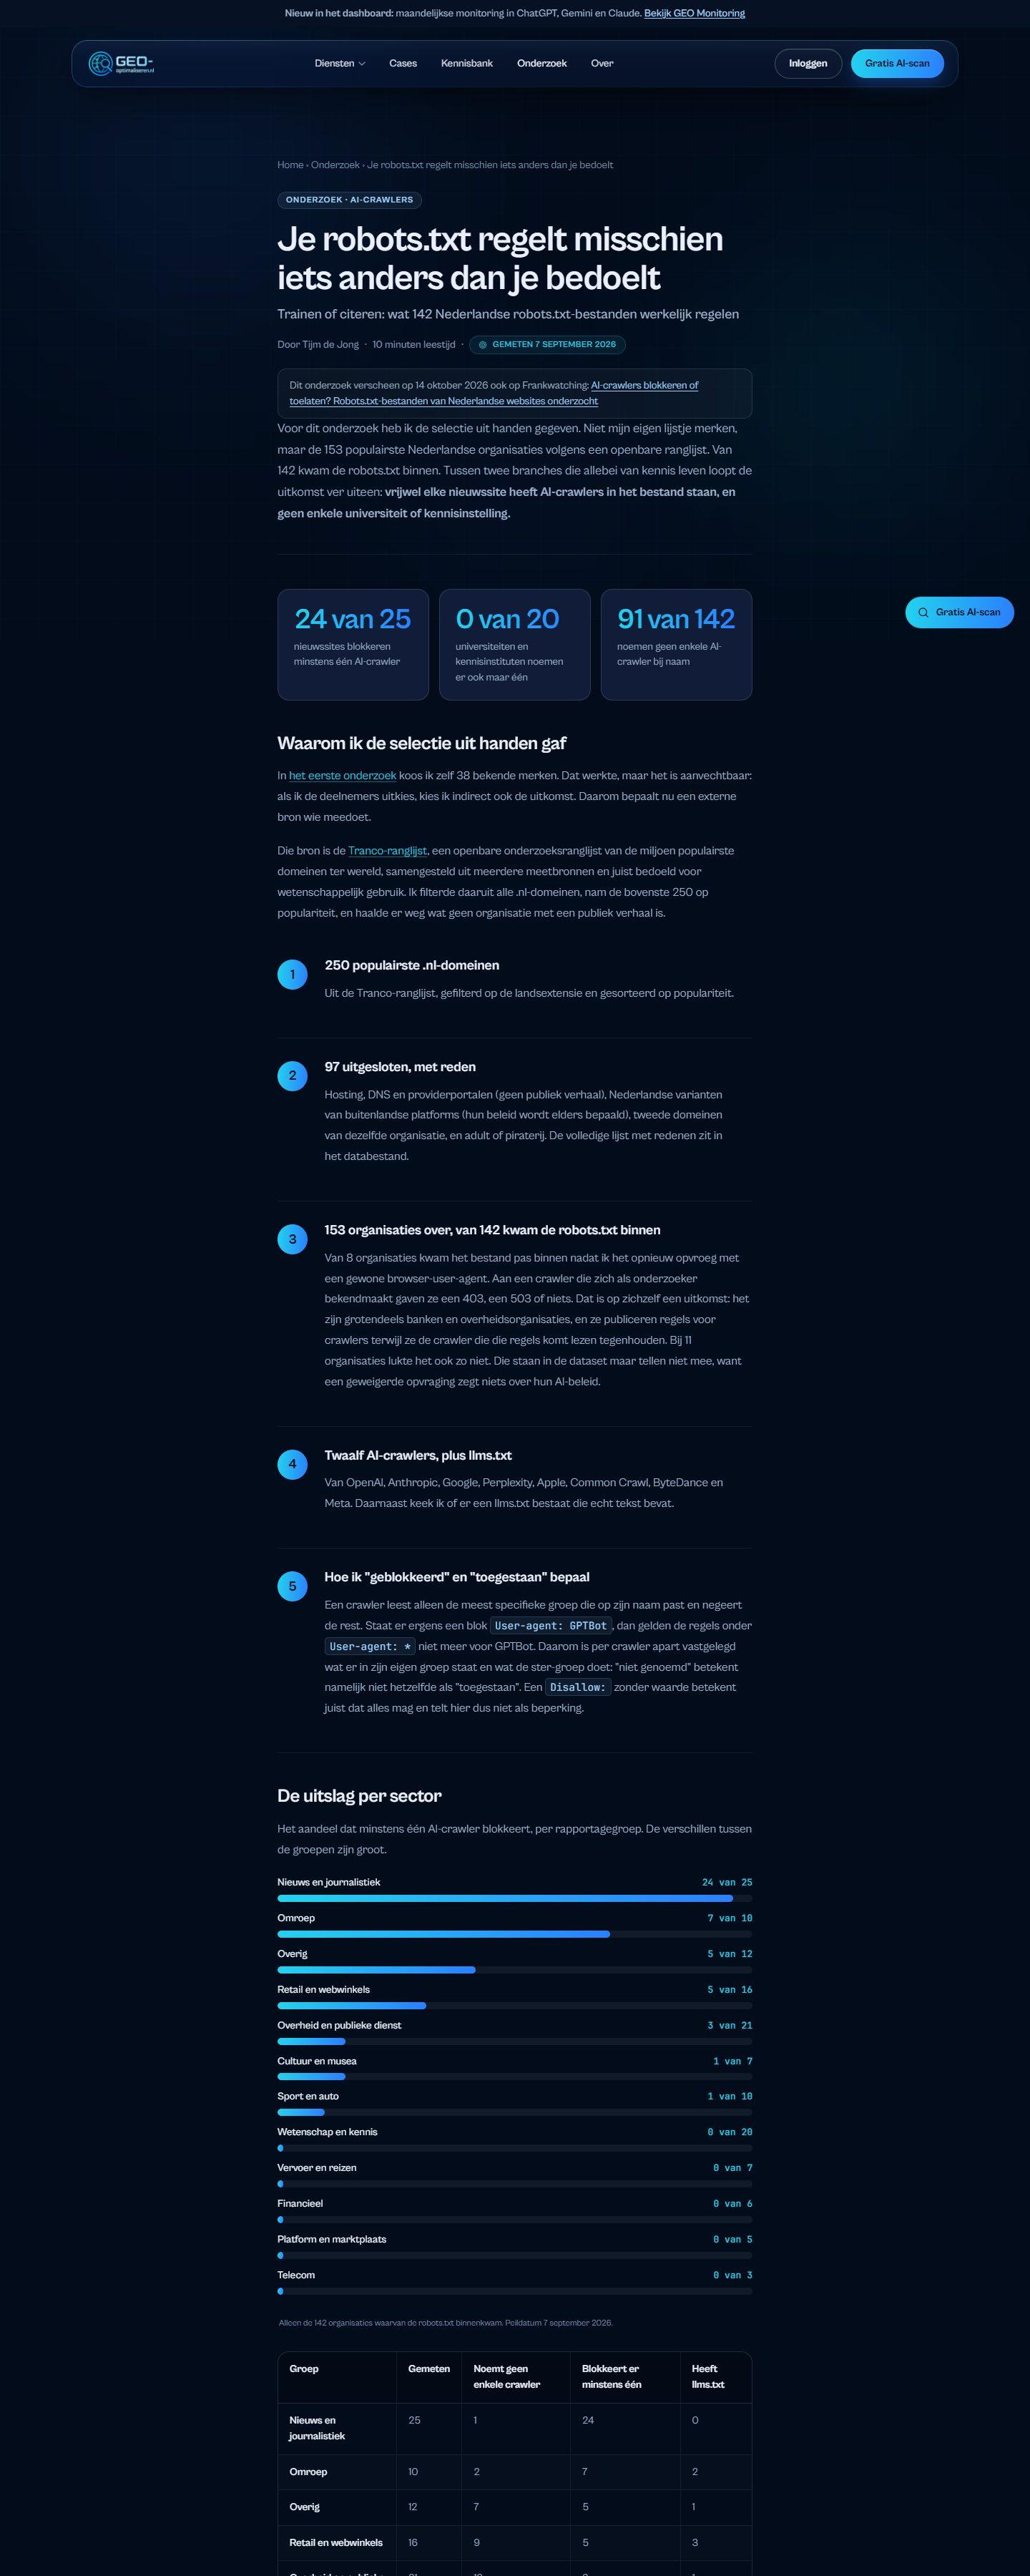
- Ik koos de organisaties niet zelf. Ik nam de 250 populairste Nederlandse domeinen uit een openbare ranglijst, en haalde er hosting, buitenlandse platforms en dubbele domeinen af. Er bleven 153 organisaties over, en van 142 kwam de robots.txt binnen.
- Per organisatie keek ik hoe ze omgaan met twaalf AI-crawlers.
- Alle cijfers zijn na te lopen: de dataset staat als download bij het onderzoek, met per uitgesloten domein de reden.
Resultaat
- 91 van de 142 organisaties noemen geen enkele AI-crawler bij naam.
- 24 van de 25 nieuwssites blokkeren er minstens één. Geen enkele van de twintig universiteiten en kennisinstituten noemt er een.
- Dertien organisaties blokkeren de crawler waarmee OpenAI traint, maar niet die waarmee ChatGPT bronnen ophaalt. Bij elf van die dertien staat die tweede crawler helemaal niet in het bestand. Het klopt dus toevallig, niet omdat iemand het zo heeft ingesteld.
Gepubliceerd
Het onderzoek verscheen op 14 oktober 2026 op Frankwatching. Het was mijn eerste artikel daar.